
上一篇我們用 Python 內建的 sqlite3 實際操作了資料庫,也看到資料真的被保存下來。
不過那時候的程式長這樣:
cursor.execute("INSERT INTO tasks (name, completed) VALUES (?, ?)", ("洗碗", 0))
rows = cursor.execute("SELECT id, name, completed FROM tasks").fetchall()
如果要把這些放進我們的 Flask API,會發現有幾件事有點麻煩。
第一,查出來的資料不是我們要的格式
SELECT 回傳的是 tuple:
(1, '洗碗', 0)
但我們的 API 要回傳的是:
{"id": 1, "name": "洗碗", "completed": false}
所以每次查完都要自己轉一次,欄位一多就很容易出錯,順序寫錯也不會有人提醒。
第二,SQL 字串會散落在程式各處
五個 API 就有五段 SQL,之後如果欄位改名,要一段一段找出來改。
第三,換資料庫就要重寫
SQLite、MySQL、PostgreSQL 的 SQL 其實有一些差異,換資料庫的時候可能要改不少地方。
這些問題,就是 ORM 想要幫我們解決的。
ORM = Object Relational Mapping(物件關聯對映)。
名字看起來很難,但概念其實很單純:
把資料庫的「表格」對應成程式裡的「類別」,讓我們可以用寫 Python 的方式操作資料庫。
對應關係是這樣:
資料表(Table) → 類別(class)
一筆資料(Row) → 一個物件
欄位(Column) → 物件的屬性
拿 Day 18 的 tasks 表來對照:
資料庫裡是:
id | name | completed
1 | 洗碗 | 0
在程式裡就會變成:
task = Task(name="洗碗", completed=False)
task.name # 洗碗
task.completed # False
新增資料原本要寫:
INSERT INTO tasks (name, completed) VALUES ('洗碗', 0);
用 ORM 就變成:
task = Task(name="洗碗", completed=False)
db.session.add(task)
db.session.commit()
查詢原本要寫:
SELECT * FROM tasks;
用 ORM 大概會變成:
db.session.scalars(db.select(Task)).all()
查出來的結果直接就是一個一個 Task 物件,可以用 task.name 取值,不用再自己把 tuple 轉成字典。
最後 SQL 還是會被執行,只是改由 ORM 幫我們產生出來。
好處:
用 Python 的方式寫,不用一直切換去想 SQL
查出來就是物件,跟程式的其他部分比較好接
換資料庫時,多數情況只要改設定
會自動幫我們做參數化查詢,比較不容易寫出有 SQL Injection 風險的程式(Day 27、28 會講)
代價(也要誠實講):
多了一層東西要學,出問題時要知道它背後產生了什麼 SQL
很複雜的查詢,用 ORM 寫可能比直接寫 SQL 還難懂
不小心寫出效率很差的查詢時,自己不容易發現
不過對現在的我們來說,ORM 的幫助比較大,所以接下來會使用它。
先講一下名字容易混淆的地方:
SQLAlchemy
Python 界最常用的 ORM 套件,本身跟 Flask 沒有關係,寫純 Python 也可以用。
Flask-SQLAlchemy
把 SQLAlchemy 包成 Flask 的擴充套件,幫我們處理跟 Flask 有關的設定,例如連線的建立與關閉。
這跟前面 Flask 和 Flask-RESTX 的關係有點像:
真正做事的是 SQLAlchemy,Flask-SQLAlchemy 是讓它在 Flask 裡用起來更順。
一樣在有啟動虛擬環境的終端機輸入:
pip install Flask-SQLAlchemy==3.1.1
裝好之後可以確認一下:
pip show Flask-SQLAlchemy
終端機安裝 Flask-SQLAlchemy 成功的畫面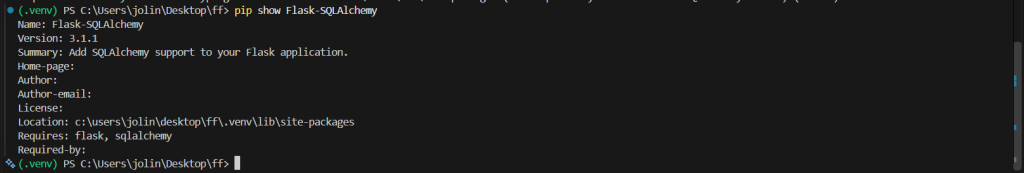
接著在 app.py 裡加入設定。
今天的目標是「能連上」,所以先加最基本的部分:
from flask import Flask
from flask_restx import Api, Resource, fields
from flask_sqlalchemy import SQLAlchemy

app = Flask(__name__)

# 設定要連到哪個資料庫
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'

db = SQLAlchemy(app)

api = Api(app, title='Task API', version='1.0')
一行一行看:
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'
這是在告訴 SQLAlchemy「要連到哪個資料庫」。
這串東西叫做連線字串,格式大致是:
資料庫種類://帳號:密碼@位置/資料庫名稱
因為 SQLite 只是一個檔案,不需要帳號密碼,所以寫起來特別短:
sqlite:///tasks.db
如果之後換成 MySQL 或 PostgreSQL,大概會長這樣(先看看就好):
mysql+pymysql://user:password@localhost/tasks
postgresql+psycopg://user:password@localhost/tasks
換資料庫的時候,主要改的就是這一行。
(正式環境的帳號密碼不會像這樣直接寫在程式裡,通常會放在環境變數,Day 26 會再提到。)
db = SQLAlchemy(app)
建立 SQLAlchemy 物件,並把 Flask app 傳給它。
跟 Day 11 的 api = Api(app) 很像,都是「把套件跟 Flask app 接起來」。
之後所有跟資料庫有關的操作,都會透過這個 db。
我們設定的是:
sqlite:///tasks.db
看起來好像會在專案資料夾直接建立 tasks.db。
但 Flask-SQLAlchemy 3.x 之後,SQLite 的相對路徑是以 Flask 的 instance 資料夾為基準。
所以實際上檔案會出現在:
你的專案/instance/tasks.db
第一次看到的時候會有點困惑,以為資料庫沒建立成功,其實只是放在 instance 裡面。
instance 資料夾是 Flask 用來放「跟這台機器有關、不該進版控」的東西,資料庫檔案放在這裡其實蠻合理的。
(之後如果用 Git,通常會把 instance/ 加進 .gitignore。)
認識 ORM:把資料表對應成類別,用 Python 的方式操作資料庫
認識 Flask-SQLAlchemy:把 SQLAlchemy 接進 Flask 的擴充套件
安裝套件、設定 SQLALCHEMY_DATABASE_URI、建立 db 物件
不過現在只是「設定好了要連哪個資料庫」,程式裡還沒有任何一張表。
資料庫還不知道我們要存的作業有哪些欄位。
下一篇就來建立第一個 Model,讓 Flask-SQLAlchemy 幫我們把資料表建出來。


 iThome鐵人賽
 看影片追技術